Lufta për dominim në tregun global të inteligjencës artificiale po nxehet, me akuza të ndërsjella se kush e vodhi atë, si do të keqpërdoret ajo dhe ndërhyrjet e pashmangshme të politikës dhe biznesit. Kina nuk dominon ende tregun, por ka filluar të krijojë një garë me veten, gjë që e ndërlikon më tej kontrollin mbi këtë sektor dhe vetë modelet e inteligjencës artificiale.
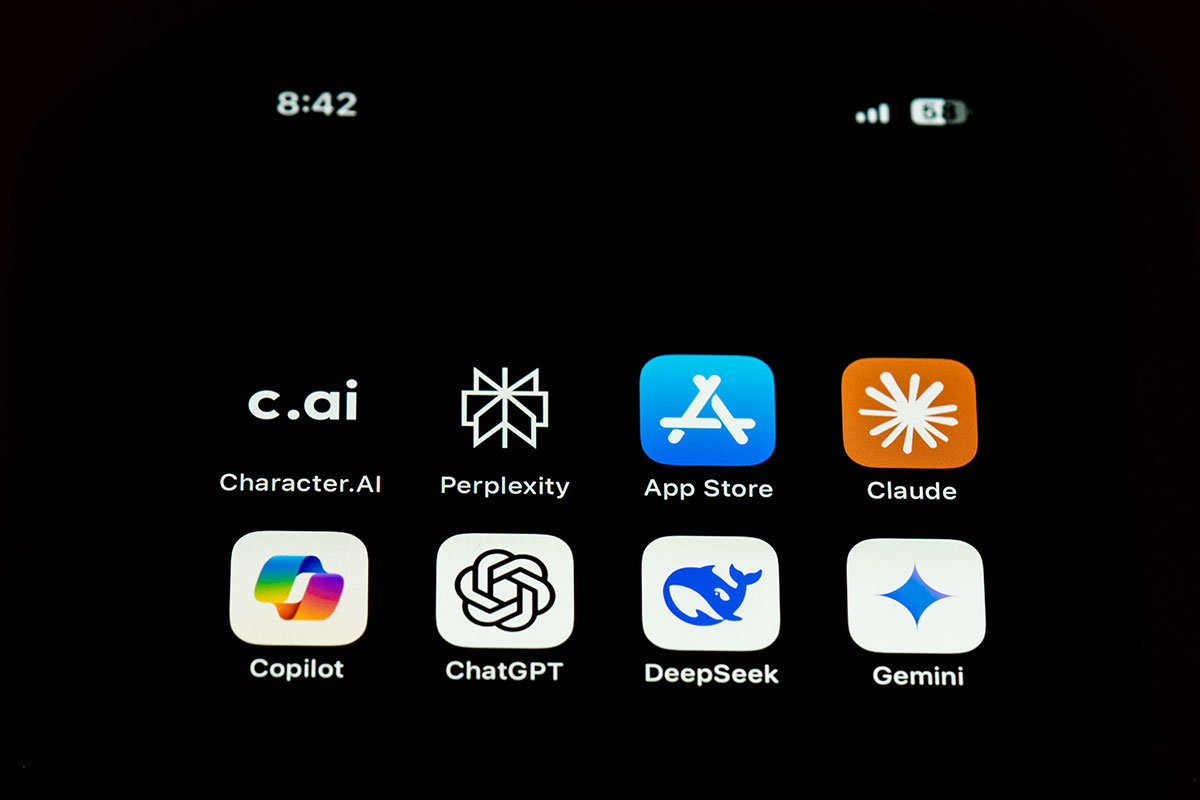
Modelet ChatGPT të OpenAI dhe inteligjencës artificiale të Google Gemini ishin më të njohurat në treg derisa doli “mrekullia” kineze DeepSeek dhe shkatërroi aksionet e rivalëve të tjerë në bursë. Ishte një mrekulli sepse krijimi i tij zgjati më pak se 10 milionë dollarë dhe jo më shumë se 2 vjet me një numër të vogël punonjësish (rreth 200), ndërsa ChatGPT mori 6.6 miliardë dollarë, 4.500 punonjës dhe u zhvillua gjatë një dekade. Një goditje shtesë për industrinë e inteligjencës artificiale dhe teknologjisë kompjuterike është fakti që inteligjenca artificiale kineze përdori modelin H800 të çipave Nvidia, të cilët ishin më të lirë se çipat e shtrenjtë të përdorur për të zhvilluar inteligjencën artificiale.
Megjithëse aksionet e Nvidia ranë në të njëjtën ditë me lançimin e DeepSec, duke humbur rreth 600 miliardë dollarë, dhe më vonë rifituan një përqindje të caktuar të vlerës, alarmi tashmë ishte aktivizuar. Kjo është frika e konkurrencës së produkteve kineze të AI (inteligjencës artificiale) dhe nivelit të transparencës dhe mbrojtjes së të dhënave personale gjatë përdorimit të inteligjencës artificiale të prodhuar në Kinë.
DeepSeek pësoi menjëherë sulme hakerash që e vështirësuan punën e tij, por fillimisht tregoi kufizime në efektivitetin e tij kur krahasohej me ChatGPT dhe Gemini. Një moment interesant është kur u bë një pyetje për statusin politik të Tajvanit, Gemini u përgjigj se statusi politik i Tajvanit është i ndërlikuar, ndërsa DeepSeek tha se është pjesë e Kinës. Paragjykimi i të dy modeleve të inteligjencës artificiale dhe fakti se ku janë krijuar secili është i dukshëm.
Arsyet e këtyre dallimeve në përgjigjet e modeleve qëndrojnë në vetë mënyrën e trajnimit, ose më mirë të “ushqyerit” të këtyre modeleve me informacion. Modelet e inteligjencës artificiale të zhvilluara nga Google ishin më konservatore se modelet e OpenAI (modelet GPT së bashku me ChatGPT). Edhe modele nga e njëjta kompani dhanë përgjigje të ndryshme në bazë të trajnimit. Modeli GPT-2 i OpenAI shprehu mbështetje për taksa më të larta për të pasurit, ndërsa modeli GPT-3 nuk shfaqi mbështetje.
Frika që u përhap në vendet perëndimore (SHBA, BE) ngriti pyetjen e mëposhtme: nëse ata mund të krijonin një model të AI për disa milionë dollarë, me një numër të vogël punonjësish, çfarë tjetër mund të bënin për të kaluar vendet perëndimore në garën për dominim në tregun e AI dhe teknologjisë kompjuterike. Frika shkoi deri në atë pikë që DeepSeek u ndalua për t’u përdorur në SHBA dhe në Senat u propozua një projektligj për një dënim me burg dhe një dënim financiar që arrin në miliona dollarë, një ndalim i përdorimit të këtij aplikacioni për nëpunësit civilë në Australi dhe Tajvan, ai nuk mund të instalohet në Itali ndërsa presidenti francez Emmanuel Macron, në intervistën e tij me median franceze në France2 dhe atë indiane në Firstpost, deklaroi se ata nuk kanë ndër mend të ndalojnë DeepSeek në Francë dhe kanë synim të fuqishëm për të bashkëpunuar me kompanitë indiane të AI dhe për të udhëhequr BE-në në luftën për tregun e inteligjencës artificiale
Për ta bërë situatën më interesante, në fund të janarit të këtij viti, gjiganti kinez i teknologjisë Alibaba (më i njohur në vendin tonë për shitjet online të produkteve kineze), gjatë Vitit të Ri Kinez, lançoi modelin e tij të inteligjencës artificiale, Kiven (Qwen). Dhe për të mos qenë mangët, aplikacioni kinez Baidu, një homolog i Facebook, ka lançuar gjithashtu modelin e tij të AI në treg.
Subjektiviteti dhe korrektësia politike në bot-ët e AI
Fama që lindi nga shfaqja e DeepSeek hapi hapësirë për kritikët e lirisë së fjalës kineze. Sulmet e para ndaj DeepSeek, përveç sulmit të hakerëve, erdhën nga mediat perëndimore kur i bënë pyetje të ndjeshme politikisht për Presidentin Xi Jinping, për Tibetin, për ngjarjet në sheshin Tiananmen. Testimi i DeepSeek me pyetje të ndjeshme politikisht u krye në kinezisht dhe anglisht. Ai ndryshoi temën e bisedës për sheshin Tiananmen, dhe gjithashtu iu përgjigj një pyetjeje në lidhje me Presidentin Xi Jinping, të bërë në të dyja gjuhët.
 Burimi: unsplash.com
Situata ishte e ngjashme me pyetjen në lidhje me Tibetin, versioni kinez u përgjigj se Tibeti është pjesë e Kinës, ndërsa versioni anglisht dha një përgjigje të gjatë me fakte historike, për ta fshirë menjëherë dhe për të ndryshuar temën e bisedës.
Por le të mos tallemi se produktet perëndimore të AI janë gjithashtu të lira për të diskutuar tema të ndjeshme politikisht. ТTestimi në ChatGPT dha rezultate të ngjashme si me DeepSeek. I pyetur nëse presidentët Biden dhe Trump janë presidentë të mirë, ai ka dhënë një përgjigje neutrale politikisht për të dy, por nuk ka munguar të renditë sukseset politike për Biden, ndërsa nuk e ka bërë këtë për Trump. Gjatë testimit në ChatGPT, megjithëse inteligjenca artificiale dha përgjigje relativisht të majta për pyetjet politike dhe sociale, testuesit vunë re se përgjigjet nuk ishin të qëndrueshme në të dy versionet (GPT 3.5 dhe GPT 4). “Bombardimi” i vazhdueshëm i bisedës me të njëjtat pyetje në versione të ndryshme prodhon përgjigje të ngatërruara dhe të pasakta.
Nëse testuesi fillon të bëjë pyetje dhe të bëjë komente kundër politikave dhe organizatave perëndimore si BE dhe NATO, ChatJPT menjëherë ose merr anën ose nuk i kritikon këto institucione. Versioni fillestar i chat-it, modeli 3, u testua dhe u “ushqye” me informacion 60% me materiale nga interneti, 22% nga përmbajtje të zgjedhura nga testuesit, 16% nga libra dhe 3% nga Wikipedia. Zgjedhja e burimit të informacionit për trajnimin e modeleve qëndron në një nga arsyet e subjektivitetit të këtyre modeleve.
Modelet e mëdha gjuhësore të mësimit përmes të cilave testohen bot-ët e AI (LLM Large Language Models) përmbajnë gjithashtu rregulla bazë për funksionimin e tyre të koduara nga krijuesit, por ato nuk mund të shërbejnë si bazë për dhënien e opinioneve politike sepse janë vetëm gjenerues informacioni sipas një kodi të caktuar.
Këtu shtrohet pyetja se si ky subjektivitet mund të rregullohet me anë të legjislacion dhe ky mjet i inteligjencës artificiale mund të jetë sa më neutral. Fatkeqësisht, përgjigjja nuk mund të jepet ende, dhe nga ana tjetër, subjektiviteti i këtyre modeleve të AI mbetet për t’u përdorur për të sulmuar krijuesit dhe vendet nga e kanë origjinën dhe për t’i akuzuar ata për përhapjen e bindjeve politike dhe propagandës.
Rregullorja më e detajuar deri më tani është miratuar nga Bashkimi Evropian në vitin 2024, me tetë pika për mbrojtjen dhe përdorimin e inteligjencës artificiale, e para prej të cilave është mospërdorimi i AI për manipulime dhe mashtrime. Megjithatë, ne ende nuk kemi parë rezultatet e kësaj rregulloreje.
Mbrojtje dhe vjedhje nga të gjitha anët
Vetë fakti që një produkt i inteligjencës artificiale është bërë për dhjetë herë me më pak para në Kinë duke përdorur çipa që tashmë janë të ndaluar të eksportohen në Kinë nga SHBA-ja, plus që ka pak punë për atë krijim pa të dhëna se sa ka financuar qeveria kineze për këtë produkt, është i habitshëm në vetvete. Edhe pse DeepSeek ka treguar se nuk është në të njëjtin nivel me ChatGPT, ai po dëshmon se mund ta kapërcejë shpejt atë. Investimet e mëdha të qeverisë amerikane në inteligjencën artificiale janë vënë në pikëpyetje nga “çmimi i lirë” i DeepSeek.
Akuzat nga mediat perëndimore dhe politikanët për vjedhje të mundshme të të dhënave nga DeepSec nëse përdoren në vendet perëndimore nuk mbajnë ujë sepse nuk ka ende një rregullore në nivel global (Brukseli po punon për të për vendet e BE-së) se si të rregullohet mbrojtja e të dhënave personale të futura në AI duke përdorur atë dhe si të rregullohet keqpërdorimi i mundshëm i AI për përhapjen e informacionit të rremë dhe propagandës politike. Kjo vlen për të gjitha modelet e inteligjencës artificiale, jo vetëm për DeepSeek, që do të thotë se edhe ata që përdorin rregullisht ChatGPT nuk mbrohen nga vjedhja e informacionit, as që qeveria amerikane do të abuzonte me aksesin tek përdoruesit pasi po përhapet paniku që qeveria kineze do ta bënte këtë përmes DeepSeek.
Lufta për dominim në tregun global të inteligjencës artificiale po nxehet, me akuza të ndërsjella se kush e vodhi atë, si do të keqpërdoret ajo dhe ndërhyrjet e pashmangshme të politikës dhe biznesit. Kina nuk dominon ende tregun, por ka filluar të krijojë një garë me veten, gjë që e ndërlikon më tej kontrollin mbi këtë sektor dhe vetë modelet e inteligjencës artificiale.
Megjithatë, çështja nuk ka të bëjë me dominimin, por me përdorimin e duhur të inteligjencës artificiale dhe mbrojtjen nga abuzimi.
Ne nuk kemi nevojë për AI në një garë manipulimi dhe shkatërrimi, por modele që inkurajojnë zhvillimin e zgjidhjeve mjekësore për sëmundjet e pashërueshme, përmirësimin e pjellorisë së tokës në pjesët e thata të botës, modele që kontribuojnë me punën e tyre në përmirësimin e përgjithshëm të jetës njerëzore. Këtu ka ende shumë punë për të bërë, por me frikë dhe rrezik të madh se njerëzimi përsëri do të devijojë nga rruga e zhvillimit dhe do të shkojë drejt vetëshkatërrimit.